martes, 7 de abril de 2020

Representación de variables.

REPRESENTACIONES GRÁFICAS.

Las representaciones gráficas de las variables es una manera rápida de comunicar información numérica, se puede decir que son la imagen de las ideas.

Completan el análisis estadístico, aumentando la información y ofreciendo una orientación visual.
No reemplaza a los cálculos que debemos hacer para las medidas estadísticas.

Encontramos una serie de normas básicas:

- Visualmente claros.
- Claramente descritos en pie de figura y en texto.
- Representa gráficamente las conclusiones del estudio.
- Hay que evitar gráficos confusos y no sobrecargarlos.

REPRESENTACIONES GRÁFICAS MÁS EMPLEADAS.


  • Variables cualitativas: 
- Gráfico de sectores.
- Gráfico de barras.
- Pictogramas.
  • Variables cuantitativas:
- Gráfico de barras.
- Histogramas.
- Polígonos de frecuencia.
- Gráficos de tronco y hojas.
  • Datos bidimensionales y multidimensionales.
- Tendencias temporales.
- Nubes de puntos (scatter plot)
- Otros gráficos multidimensionales.

VARIABLES CUALITATIVAS.
Podemos representarlas mediante gráfico de sectores, gráfico de barras y pictogramas.

GRÁFICO DE SECTORES.
El área de cada sector circular es proporcional a la frecuencia (absoluta o relativa)de las categorías de la variable.
No usar con variables ordinales y no es recomendable para más de 3 o 4 categorías.
Sólo muestra una variable a la vez, si se quiere hacer comparaciones se tienen que hacer dos diagramas de sectores.

Los errores son: utilizar para variables policotómicas u ordinales y utilizar para representar muchas categorías.


DIAGRAMAS DE BARRAS.
Se usa también en variables cualitativas, con este tipo evitamos que se pierdan los atributos de orden o jerarquía.
Las frecuencias absolutas o relativas de todas las categorías de una variable se muestran fácilmente con este tipo de gráfico. Cada barra representa una categoría y la altura de esta, la frecuencia.
Las barras deben estar separadas y es importante que el eje Y empiece en la frecuencia 0.

Un error en estos gráficos es comparar las frecuencias absolutas y no son comparables.
En una variable cuantitativa es preferible un histograma, antes que este tipo de representación.

PICTOGRAMAS
Es un tipo gráfico similar al diagrama de barras, pero utiliza figuras proporcionales a la frecuencia en lugar de barras.
Generalmente se emplea para representar variables cualitativas.
Este tipo de gráfico no permite buenas comparaciones, para realizar su gráfica primero se deben escoger las figuras que sean alusivas al tema y se les asigna un valor.


VARIABLES CUANTITATIVAS.
Las representaciones más usadas en estas variables son los histogramas y los polígonos de frecuencia.

HISTOGRAMA.
Es el más usado, ya que es el más sencillo de interpretar.
Es una sucesión de rectángulos contiguos construidos sobre una recta.
Representa a una variable continua con sus datos agrupados en intervalos.
La base de cada rectángulo representa la amplitud de cada intervalo y la altura está determinada por la frecuencia. Cada intervalo representado en el histograma ocupa un rectángulo.

POLÍGONOS DE FRECUENCIA.
Une los puntos medios de las bases superiores de los rectángulos.
Se acostumbra a prolongar el polígono hasta puntos de frecuencia cero.
Un polígono de frecuencia permite ver con gran claridad las variaciones de la frecuencia de una clase a otra.
Son muy útiles cuando se pretende comparar dos o más distribuciones.
La suma de las áreas de los rectángulos de un histograma es igual al área limitada por el polígono de frecuencia y el eje X.
El polígono de frecuencia resume, en una sola línea, el resultado del histograma correspondiente.

GRÁFICOS DE TRONCO Y HOJAS.
Representa las variables cuantitativas continuas.
Cada dato de la serie se divide en dos partes:
- En la primera columna se representa los tallos.
- En la segunda columna las hojas.

Es un diagrama híbrido entre una tabla y una gráfica.
Tiene la ventaja de no perder información individual, identifica la distribución de los datos y si existen clases faltantes.
Esto hace que para muchos autores sea la representación gráfica de elección.

GRÁFICOS PARA DATOS BIDIMENSIONALES.
Encontramos tendencias temporales, diagramas de dispersión (nube de puntos o "scatter plot") y diagrama de estrellas.

DIAGRAMAS DE DISPERSIÓN.
Representan el comportamiento de dos variables continuas en un grupo de individuos.
En el eje x: se representa la variable independiente.
En el eje y: la variable dependiente.
La imagen del diagrama nos da una idea de la correlación de las variables.

DIAGRAMA DE ESTRELLAS.
Representar un conjunto de variables cuantitativas y comparar entre diferentes unidades de análisis (individuos/ conglomerados).
Cada variable representa un vértice del diagrama de estrella. Da una idea del comportamiento del conjunto de variables
Permite comparativas con "Gold Standard".

TENDENCIAS TEMPORALES.
Una serie temporal se define como una colección de observaciones de una variable recogidas secuencialmente en el tiempo. Estas observaciones se suelen recoger en instan- tes de tiempo equiespaciados. Si los datos se recogen en instantes temporales de forma continua, se debe o bien digitalizar la serie, es decir, recoger sólo los valores en instantes de tiempo equiespaciados, o bien acumular los valores sobre intervalos de tiempo.


viernes, 27 de marzo de 2020

Medidas para variables cuantitativas.


RESUMEN NUMÉRICO DE UNA SERIE ESTADÍSTICA.

Podemos resumir una serie de observaciones mediante "estadístico".
Encontramos tres tipos de medidas estadística:

  • Medias de tendencia central: las medidas o parámetros de centralización nos indican en torno a qué valor se distribuyen los datos, y son:
- Mediana.
- Media.
- Moda.

  • Medidas de posición: dividen un conjunto ordenado de datos en grupos con la misma cantidad de individuos.
- Cuartiles.
- Deciles.
- Percentiles.

  • Medidas de dispersión o variabilidad: dan información acerca de la heterogeneidad de nuestras observaciones.
- Rango.
- Desviación media.
- Varianza.
- Desviación típica.
- Coeficiente de variación.

Medidas de tendencia central.

Media aritmética o media, (x).
Se calcula para las variables cuantitativas. Es la suma de todos los valores de la variable observada entre el total de observaciones.
Es la medida más calculada y utilizada en estadística descriptiva.

Propiedades de la media:
  • La suma de las desviaciones respecto a la media es igual a 0.
  • La media no se altera por una transformación  lineal de escala:
- Si un conjunto de datos cuya media es X, se le suma a cada datos una constante K, la media aumenta en K unidades.
- Si un conjunto de datos cuyo media es X, se multiplica cada dato por una constante K, la media queda multiplicada por K.
  • Es muy sensible a las puntuaciones extrema.

Otras medias:
  • Media geométrica (G): raíz N-ésima del producto de los N valores observados.
  • Media armónica (H): inverso de la media aritmética de los inversos de los valores de la variable.
  • Media aritmética ponderada (x): media aritmética de la suma del producto de cada valor por el peso o relevancia asignada al mismo.

Mediana.
La mediana es la puntuación que ocupa la posición central de la distribución.
Para poder hallarla necesitamos que nuestros datos estén ordenados, de forma creciente o decreciente.
Es el valor de la observación tal que un 50% de los datos es menos y otro 50% es mayor.
Si la media y la mediana son iguales, la distribución de la variable es simétrica.
A diferencia de la media de la media aritmética, la mediana es más robusta y menos sensible a los valores extremos.
Cuando la muestra posee muy pocos daros, o existen valores extremos o datos censurados-truncados, debemos calcular siempre la mediana.
Si el número de observaciones es impar, el valor que se tomará sera el que ocupa la posición: (n+1)/2.

Moda.
Es el valor que más se repite.
Las distribuciones que contienen una sola moda se llaman unimodales. Si hay más de una se dice que la muestra es bimodal, si son dos modas, o multimodal, si es más de dos.
Se puede calcular para cualquier variable, aunque es la medida de tendencia central menos empleada.
Podemos decir que es una distribución unimodal simétrica cuando los valores de la media aritmética, mediana y moda coinciden.
Si los datos están agrupados, se habla de clase modal y corresponde al intervalo en el que el cociente entre la frecuencia relativa y amplitud es mayor (hi/ci).


Medidas de posición.
Se calcula para variables cuantitativas. Sólo se tiene en cuenta la posición de los valores en la muestra, como la mediana.
Se define el cuantil de orden "n" como un valor de la variable por debajo del cual se encuentra una frecuencia acumulada, n.
Los cuantiles más usuales son los percentiles, los deciles y los cuartiles, según se divida la muestra ordenada en 100, 10 ó 4.


Percentiles.
Dividen la muestra ordenada en 100 partes,los percentiles serían los 99 puntos o valores que dividen la distribución en cien partes iguales. P(n).
El percentil "i" P(i): valor donde las observaciones ordenados en forma creciente el i% de ellas son menores que él. Asimismo, el (100-i)% restante son mayores.
Para buscar la posición de un percentil en una serie de datos agrupados, buscamos el intervalo en el que la frecuencia relativa acumulada (Hi) sea superior al valor del percentil.

Deciles.
Dividen la muestra ordenada en 10 partes. Los deciles son los nueve valores que dividen a la distribución en diez partes iguales.
Cada parte el 10% de los valores de la distribución. Se representan por la letra D.
El decil "i" D(i): valor donde las observaciones ordenados en forma creciente el i/10% de ellas son menores que él. Asimismo, el (100-i)% restante son mayores.
El valor del D5 corresponde al valor de la mediana y, por tanto, al de P50.

Quartiles.
Dividen la muestra ordenada en 4 partes. Son los valores que dividen la distribución en cuatro partes iguales, cada parte incluye un 25% de los valores de esta variable. Se representan por Q1, Q2, Q3.
- El Q1, primer cuartil indica el valor que ocupa una posición en la serie numérica de forma que el 25% de las observaciones son menores y que el 75% son mayores.
- El Q2, es el segundo cuartil, indica el valor que ocupa una posición en la serie numérica de forma que el 50% de las observaciones son mayores y el 50% son mayores. Por tanto, el Q2 coincide con el valor del D5, con el valor de la mediana P50.
- El Q3, tercer cuartil indica el valor que ocupa una posición en la serie numérica de forma que el 75% de las observaciones son menores y un 25% mayores.
- El Q4, cuarto cuartil que indica que es el mayor de la serie numérica.

Medidas de dispersión.
La información aportada por las medidas de tendencia central es limitada.

Rango o recorrido: (R).
Es la medida de dispersión más simple y consiste en tomar la puntuación mayor y restarle la puntuación menor.
La principal limitación del rango es que al tener en cuenta solamente los valores más altos y bajos, se ve muy afectado por los valores extremos. 


Recorrido intercuartílico: (RI)
Diferencia entre el tercer y el primer cuartil.


Rango Semiintercuartil:
Conocido también como desviación cuartil, o espectro semicuartil. En su cálculo utiliza los valores intermedios y no los extremos, lo que confiere una mayor estabilidad al rango.


Desviación media: (DM).
Es la media aritmética de las distancias de cada observación con respecto a la media de la muestra.


Varianza: (S2).
Es la media de los cuadrados de las diferencias entre cada valor de la variable y la media aritmética de la distribución.
Siempre tiene un valor positivo.
Se mide en unidades de la variable estudiada (al cuadreado).
Cuanto menor sea la varianza mayor será la homogeneidad y menor dispersión.

Denominador de la varianza:
  • n para la muestra (s2).
  • n-1 para la población: varianza insesgada o cuasivarianza.

Desviación típica o estándar: (S).
Expresa la dispersión de la distribución mediante un valor que siempre es positivo y en las mismas unidades de medida de la variable, siendo la medida de dispersión más utilizada en estadística descriptiva.
Cuando los datos están muy alejados de la media, el numerador será grande y la varianza y la desviación típica también lo serán.
Al aumentar el tamaño de la muestra, disminuye la varianza y la desviación típica.

Propiedades:
  • La desviación típica será siempre un valor positivo o cero, en el caso de que las puntuaciones sean iguales.
  • Si a todos los valores de la variable se les suma un número la desviación típica no varía.
  • Si todos los valores de la variable se multiplican por un número la desviación típica queda multiplicada por dicho número.
Observaciones:
  • La desviación típica, al igual que la media y la varianza, es un índice muy sensible a las puntuaciones extremas.
  • En los casos que no se pueda hallar media, tampoco será posible hallar la desviación típica.
  • Cuanta más pequeña sea la desviación típica mayor será la concentración de datos alrededor de la media.

Coeficiente de variación: (CV).
También recibe el nombre de variabilidad relativa, puesto que es una medida de dispersión relativa de los datos.
Se calcula dividiendo la desviación típica entre la media de la muestra, y expresado en el porcentaje.
El CV es una medida adimensional y nos permite comparar la dispersión o variabilidad de dos o más grupos. Sin embargo, no debe usarse cuando la variable presenta valores negativos o donde el valor 0 sea una cantidad fijada arbitrariamente.


Distribuciones normales.
En estadística se llama distribución normal, distribución de Gauss o distribución gaussiana, a una de las distribuciones de probabilidad de variable continua que con más frecuencia aparece en fenómenos reales.
La gráfica de su función de densidad tiene una forma acampanada y es simétrica respecto a los valores de posición central (media, mediana y moda, que coinciden en estas distribuciones).
Esta curva se conoce como campana de Gauss.


Medidas de forma.

Asimetrías y Curtosis.
Las medidas de forma indican si la distribución es simétrica y el grado de apuntamiento, tomando siempre como referencia la curva normal.


Asimetrías.
Coeficiente de asimetría de una variable: grado de simetría de la distribución de sus datos en torno a su media.
Las distribuciones asimétricas, también llamadas sesgadas, se caracterizan porque el pico de la misma se encuentra descentrado (no simétrica), apareciendo una cola más larga que la otra.
Es asimensional y adopta valores entre -1 y +1.

Interpretación del coeficiente de asimetría:
  • g1= 0. Distribución simétrica.
  • g1> 0. DIstribución simétrica asimétrica positiva, la cola de distribución es más larga hacia la derecha y los valores más elevados están en la izquierda.
  • g<0. DIstribución asimétrica negativa, la cola más larga queda hacia la izquierda, y los valores más elevados a la derecha.
Curtosis o apuntamiento.
Coeficiente de apuntamiento o curtosis de una variable, sirve para medir el grado de concentración de los valores que toma en torno a su media.
Se elige como referencia una variable con distribución normal, donde el coeficiente de curtosis es 0.
Adopta también valores entre -1 y 1.Es una medida adimensional.

Interpretación:
  • g2= 0. Distribución mesocúrtica. Presenta un grado de concentración medio alrededor de los valores centrales de la variable.
  • g2> 0. Distribución leptocúrtica. Presenta un elevado grado de concentración alrededor de los valores centrales de la variable.
  • g2<0. Distribución platicúrtica. Presenta un reducido grado de concentración alrededor de los valores centrales de la variable.


viernes, 20 de marzo de 2020

Introducción a la estadística descriptiva: Medidas resumen variables cualitativas. Medidas de frecuencia. Proporciones, razones y tasas. Construcción de tablas de frecuencia.

Estadística descriptiva y estadística inferencial.
La estadística trata del recuento, ordenación y clasificación de los datos obtenidos por las observaciones, para poder hacer comparaciones y sacar conclusiones.

- Estadística descriptiva.
Los procedimientos están dirigidos a la organización y descripción de un conjunto de datos. 
Organiza de manera clara y fácil de analizar, resume los datos, explora la relación entre variables y es preliminar antes de la inferencia. Ademas, es el tipo de estadística que normalmente vemos en los medios de difusión.

-Estadística inferencial.
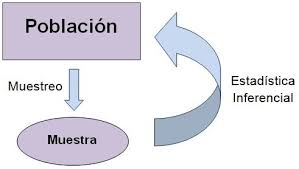
Los procedimientos se orientan a realizar inferencias, es decir, extraer conclusiones a partir de hechos, sobre una población a partir de las características conocidas para una muestra extraída de ella.
Utiliza muestras de datos para sacar conclusiones sobre poblaciones más grandes. Este tipo de método se encuentra más frecuentemente en artículos publicados sobre investigación científica.
A partir del cálculo de probabilidad y a partir de datos de las muestras, concluye:
- Estimaciones.
- Decisiones.
- Predicciones.
- Generalizaciones sobre un conjunto mayor de datos.

Variables.
Las variables es cada una de las características o cualidades que poseen los individuos de una población.

Encontramos dos tipos de variables estadísticas:
- Variables cualitativas: aquellas características o cualidades que no pueden ser medidas con números.
- Variables cuantitativas: aquellas que se expresan mediante un número, se pueden realizar operaciones aritméticas con ellas.

Como mencioné en la entrada anterior, dentro de las variables cualitativas y cuantitativas encontramos:

Presentación de datos.
Las tablas de frecuencia y las representaciones gráficas son dos maneras equivalentes de presentar la información.
- Tabla de frecuencia: es una ordenación en forma de tabla de los datos estadísticos, asignando a cada dato su frecuencia correspondiente. Muestran FRECUENCIAS en columnas y las CATEGORÍAS de las variables en las filas.

Requisitos:
Son autoexplicativas.
Son sencillas y de fácil compresión.
Tienen título, breve y claro.
Indican lugar, fecha  y fuente de información.
Incluye las unidades de medida en cada cabecera-.
Indicas frecuencias absolutas y relativas.

Variables continuas.
Tablas de frecuencias de datos agrupados.
La manera de hacerlo sería la siguiente: 
  1. Calculamos el recorrido (rango), diferencia entre el mayor y el menor de los datos de una distribución estadística. Re= xsub(n)-xsub(1)= 6.1 - 3.3= 2.8
  2. Cuando no nos dice nada del nº de intervalos, se obtiene calculando la raíz cuadrada del nº de datos observados. Veremos que la raíz cuadrada de 40 es igual a 6,32, por lo tanto tomaremos 6 intervalos.
  3. Como el recorrido es 2.8, si lo dividimos por el nº de intervalos tendremos la amplitud de cada uno de ellos y así: 2.8/6 = 0,46.
- Definición de intervalos.
- Definición de extremos de los intervalos.
- Definición de amplitud o distancia entre los extremos.
Cálculo de la marca de clase de cada intervalo.


- Frecuencia absoluta: es el número de veces que aparece un determinado valor. Se representa por f¡. La suma de las frecuencias absolutas es igual al número total de datos, se representa por N.
- Frecuencia relativa: es el cociente entre la frecuencia absoluta de un determinado valor y el número total de datos. Se puede expresar tantos por cientos y se representa por h¡.
- Frecuencias acumuladas: La frecuencia acumulada es el resultado que se obtiene de la suma sucesiva de las frecuencias absolutas o relativas, cuando se realiza de menor a mayor según sus valores. En otras palabras, se entiende como la cantidad de veces que un determinado evento se repite en una muestra o algún experimento. (Σf¡ ó Σh¡). Σ= sigma, suma o sumatoria.


Indicadores/ Concepto de indicador:
 En el análisis descriptivo se usan en gran medida los números relativos, que son la expresión de la relación de dos o más cantidades.
La frecuencia absoluta no puede ser un indicador, pues le falta un denominador que la relacione con el tamaño de la muestra o población, y/o el período en el que se presentaron los eventos.
Existen muchos indicadores elaborados en:
- Instituto Nacional de Estadística (INE).
- Instituto de Estadística de Andalucía (IEA).
- Centro de Investigaciones Sociológicas (CIS).

Se define como indicador como la medida de la frecuencia de un determinado suceso en una población, expresado como un número que puede ser:
- Proporción.
- Tasa.
- Razón.
- Odds.

Los indicadores siempre están formados por un numerador y un denominador, es decir, es el resultado del cociente entre dos magnitudes.

Proporciones.
Se define como una medida resumen para variables cualitativas, que consiste en la comparación, a través de un cociente (división) entre un subconjunto y el conjunto al que pertenece.

Características a tener en cuenta:
  1. El numerador siempre está incluido en el denominador.
  2. Adopta valores reales entre 0 y 1, expresando la frecuencia relativa del suceso que medimos.
  3. Se suele multiplicador por 100, para calcular una mejor compresión, expresando los porcentajes correspondientes.
  4. Si el suceso que medimos es muy poco frecuente, podemos multiplicar por 1000, por 10000, etc.
Tasas.
 Es una medida que expresa el riesgo de ocurrencia del evento estudiado.
En realidad, es una proporción pero con relación espacial y temporal. El denominador incluye una unidad de tiempo.
Consiste en la comparación, a través de una división, entre el número de veces que ocurre un cierto tipo de evento y la población en la que puede ocurrir dicho evento en un tiempo determinado.
Usualmente el resultado de tal división consiste en una cifra fraccionaria menor a 1, por lo que el resultado suele ser multiplicado por alguna constante que sea múltiplo de 10.

Incidencia.
Es el número de casos nuevos de una enfermedad que ocurren en un período específico de tiempo, en una población a riesgo de desarrollar la enfermedad.
La incidencia mide cambio: de ausencia a presencia de enfermedad, de vivo  a muerto, de no tener una característica a tenerla.
La incidencia es una medida de riesgo.

- Incidencia acumulada (proporción de incidencia): riesgo de que se produzca el suceso.
- Tasa de incidencia (densidad de incidencia): Velocidad de aparición de nuevos casos con respecto al tamaño de la población.

Incidencia acumalada (proporción de incidencia).
Se calcula utilizando nu período de tiempo durante el cual consideramos que todos los individuos de la población están a riesgo de la enfermedad.
Es la proporción de sujetos que desarrollan la enfermedad, en un período de tiempo, del total de la población a riesgo al inicio del período.
Mide el riesgo promedio de padecer la enfermedad (probabilidad de desarrollar la enfermedad).

IA= Nuevos casos en un tiempo determinado/ población a riesgo en t0 (tiempo inicial).

  1. Mide la probabilidad de tener la enfermedad (evento)
  2. No tiene unidades. Es una proporción ( se expresa como %...)
  3. Valores entre 0 y 1.
  4. No lleva implícito el período de tiempo, con lo cual debe expresarse siempre.
Condiciones:
- No puede haber pérdidas en el seguimiento.
- Se siguen a todos los sujetos durante todo el período.
- No permite inferir fuera del período de estudio.


Tasa de incidencia (o densidad de incidencia).
Con frecuencia, no todos los individuos a riesgo ( denominador), son seguidos durante el mismo período de tiempo.
Si se disponen de los diferentes tiempos de observación de los diferentes individuos, se puede calcular la densidad de incidencia o tasa de incidencia.
Es necesario especificar la unidad de tiempo a las que se refiere la tasa (personas- año; personas-mes, personas- semana, etc).

Pautas:
  1. Se mide en unidades de tiempo (-1).
  2. No son proporcionales, es una tasa instantánea.
  3. Expresa la "tasa" a la cual ocurren los eventos en sujetos de la población en riesgo en cualquier momento.
  4. Expresa la velocidad: la tasa de cambio instantáneo o la rapidez con la que se desarrolla el evento en la población.
Tasa: datos agregados.
- Densidad de incidencia: tasa obtenida de datos individuales.

Densidad de incidencia basada en datos individuales.

Densidad de incidencia= nuevos casos/ personas- tiempo a riesgo.

Personas - tiempo:
- Suma de tiempos que los individuos están a riesgo de desarrollar el evento.
- Las unidades a utilizar dependen del investigador. Los eventos poco frecuentes suelen describirse en personas- año o un múltiplo del mismo (100 o 1000 personas - año). En cambio, en los eventos más frecuentes se pueden utilizar personas- semana o personas- día.

Razones o "ratios".
Es una medida de resumen para variables cualitativas que consiste en la comparación, a través de una división entre dos conjuntos.
Los dos conjuntos son distintos, es decir, uno no incluye al otro.
El numerador del cociente, por tanto, no está incluido en el denominador, como sí sucedía en las proporciones.

Odds o ventaja.
El cociente entre la proporción o probabilidad de ocurrencia de un evento y la probabilidad (complementaria) de no ocurrencia, se denomina con el término en inglés "odds", empleado en el lenguaje de apuestas.
No hay un término exacto en español, no consenso en su traducción. El más aceptado es "ventaja" u "oportunidad".
La odds representa la frecuencia de un aspecto relativa a los sujetos que no presentan dicho aspecto, por lo que es un tipo especial de razón.
Sus valores van desde 0, que serían eventos que nunca ocurren, hasta infinito, que serían los que ocurren con mucha frecuencia.
Medidas de asociación: relaciones entre proporción, ratios y odds.
La magnitud de asociación entre dos fenómenos, puede estimarse a través de medidas que relacionen proporciones, tasas y odds.
Es lo que se llaman "medidas de asociación" y dependiendo del tipo de estudio, se usarán una u otra.
Las tres partes más importantes son:
  • Razón de prevalencias: estudios descriptivos de corte transversal. Realiza una ratio entre dos prevalencias (proporciones). Es la razón entre la proporción de enfermos expuestos y la proporción de enfermos no expuestos. Cuantifica una estimación de la asociación enre el factor de exposición y la enfermedad.
Si el valor se aproxima a 1, la enfermedad se distribuye por igual entre los expuestos y los no expuestos.

R.p.= P.e/P.ne. MAGNITUD DE LA ASOCIACIÓN.
  • Riesgo relativo o razón de riesgos: estudios de observaciones de seguimiento o estudios experimentales. Realiza un ratio entre dos incidencias acumuladas (proporciones) o dos densidades de incidencia (tasas). Es la razón entre el riesgo en los expuestos y el riesgo en los no expuestos. Cuantifica el incremento en el riesgo producido por la exposición.
Si el valor se aproxima a 1, la enfermedad o el suceso aparece de forma similar entre los expuestos y los no expuestos.

RR= I.e/ I.ne. MAGNITUD DE LA ASOCIACIÓN.
  • Odds ratio: estudios de casos y controles. Realiza una ratio entre dos medidas odds.  Es la razón entre los odds de los casos y los odds de los controles.
O.R.= ODDS Casos/ ODDS Controles

Valores posibles de 0 a 1.


Reflexión

La estadística va de "riesgo, de recompensas, de azar". Básicamente,  la estadística va de entender datos . Y los datos son hoy má...